T'as déjà été dans cette salle-là. Quatre heures dans le post-mortem, personne a dormi, pis la chose que le responsable de la sécurité arrête pas de ramener sur la table, c'est que le code est correct : il fait exactement ce que le billet demandait, il va chercher les enregistrements du compte demandé, il pagine à cinquante, il retourne du JSON. Propre. Révisé. Pipeline vert, deux approbations, déployé un jeudi après-midi.
Pis là quelqu'un relit le billet. À voix haute. Au complet, et ce qui manque dedans, c'est pas une ligne de code, c'est une phrase en français que personne a jamais tapée : ce point d'accès doit retourner uniquement les enregistrements qui appartiennent à l'appelant authentifié. Pas dans la story. Pas dans les critères d'acceptation. Pas dans le definition of done collé en haut du tableau depuis 2023. Le modèle a pas brisé une règle de sécurité. Il a rempli un silence, pis il l'a rempli avec quelque chose qui avait l'air parfaitement raisonnable à trois humains différents qui ont tous approuvé sans se poser une seule question de plus.
Pourquoi blâme-t-on toujours le modèle quand le code généré par IA ouvre une brèche ?
Parce qu'un modèle fait un bien meilleur méchant qu'une phrase manquante. Regarde la couverture après n'importe quel incident impliquant du code écrit par un assistant : le modèle a halluciné, le modèle a été négligent, le modèle aurait dû savoir, pis rendu au neuvième paragraphe il y a un détail sur une politique que personne a configurée. Mauvais étage. C'est pas un cadrage stupide, il vise juste un cran trop bas, et il produit un remède qui peut pas marcher : attendre patiemment un modèle qui va refuser d'écrire du code vulnérable.
Au moins, on a commencé à compter, ce qui était pas vrai il y a un an. Le Systems Software and Security Lab de Georgia Tech opère depuis mai 2025 un traqueur qui fait quelque chose que personne d'autre faisait : prendre une vulnérabilité publiée, remonter son commit correctif à travers l'historique Git, et vérifier si le code fautif porte la signature d'un outil d'IA, une étiquette de coauteur ou un courriel de bot. Lent. Pas glamour pantoute. C'est aussi la première vraie mesure que quelqu'un possède de la fréquence du phénomène dans la vraie vie, et la courbe du premier trimestre 2026 est assez raide pour être inconfortable à lire.
6 → 15 → 35
Nouvelles vulnérabilités introduites par IA confirmées en janvier, février et mars 2026, retracées commit par commit. Mars tout seul dépasse l'année 2025 au complet. Un traqueur couvrant une cinquantaine d'outils de codage IA comptait 74 cas confirmés à ce moment-là, dont 14 critiques et 25 de sévérité élevée, et le chercheur derrière le projet dit sans détour que c'est un plancher, pas un plafond. Ce sont les chiffres tels que rapportés en mars 2026 ; le compte a continué de grimper depuis.
Sources : Systems Software and Security Lab, Georgia Tech, Bad Vibes: AI-Generated Code Is Vulnerable, Researchers Warn, pour les 74 cas confirmés et la répartition 14 critiques / 25 élevés ; et Hanqing Zhao, l'assistant de recherche derrière le Vibe Security Radar, en entrevue dans Infosecurity Magazine le 26 mars 2026, pour les chiffres mensuels 6, 15 et 35, le lancement en mai 2025, la cinquantaine d'outils couverts et l'estimation de cinq à dix fois. Sources de données : CVE.org, National Vulnerability Database, GitHub Advisory Database et OSV. Chiffres tels que rapportés en mars 2026 ; le tableau de bord public du projet, vibesecradar.com, atteignait 272 cas catalogués en date du 26 août 2026.
Prends le chiffre avec précaution, parce que le labo le prend avec précaution. Zhao dit carrément que le vrai total est probablement de cinq à dix fois plus élevé, vu que la plupart des commits assistés par IA ont aucune signature dans les métadonnées et qu'une grosse partie des vulnérabilités reçoivent jamais d'identifiant public. Fait qu'il sous-compte. Volontairement. Ce qu'il mesure proprement, c'est la direction, et c'est ça qui devrait changer ton prochain trimestre plutôt que ton opinion sur un fournisseur en particulier. La direction a pas molli non plus : à la dernière mise à jour publique du tableau de bord, le 26 août 2026, il listait 272 cas catalogués plutôt que 74, avec certains mois antérieurs rebalancés à mesure que les confirmations rentraient.
Qu'est-ce qui manque exactement quand personne ne spécifie une exigence de sécurité ?
La frontière. Presque toujours la frontière, et elle se présente sous trois formes : qui a le droit de lire ou d'écrire telle rangée, quelles entrées le système doit refuser net, et dans quelles circonstances une vérification d'authentification peut légitimement être sautée. Ça, c'est des exigences. C'est pas des détails d'implémentation, c'est pas quelque chose qu'une équipe de sécurité visse par-dessus dans un sprint futur, et c'est le genre d'affaire qu'un bon analyste d'affaires écrit en un après-midi à condition que quelqu'un pense à lui demander.
Voici le résultat qui m'a fait changer d'idée sur toute la catégorie, et j'arrivais là-dedans en m'attendant au contraire. Une étude de vérification formelle déposée sur arXiv en avril 2026 a poussé 3 500 artéfacts de code produits par sept modèles largement déployés dans le solveur de satisfiabilité Z3, générant des preuves mathématiques plutôt que des correspondances de motifs, et parmi ses trois expériences secondaires il y en a une qui est discrètement dévastatrice : quand on leur demande de réviser du code du même type, les modèles identifient leur propre sortie vulnérable 78,7 % du temps. Ils le savent. Ils la génèrent quand même à 55,8 %, parce que générer et réviser sont deux tâches différentes et qu'une seule des deux se fait poser la question de sécurité à voix haute.
4 points
C'est de combien l'ajout d'instructions de sécurité explicites au prompt a déplacé le taux moyen de vulnérabilité, contre une base de 55,8 % sur 3 500 artéfacts produits par sept modèles. Les mêmes modèles signalaient leur propre sortie vulnérable 78,7 % du temps quand on leur demandait de la réviser au lieu de l'écrire. Dire à un modèle de faire attention, c'est pas une exigence. Ça ne nomme ni acteur, ni objet, ni frontière, fait qu'il reste rien qu'une personne ou un test pourrait vérifier.
Source : Dominik Blain et Maxime Noiseux, Broken by Default: A Formal Verification Study of Security Vulnerabilities in AI-Generated Code, arXiv:2604.05292, déposé le 7 avril 2026. 500 prompts critiques pour la sécurité répartis sur cinq catégories CWE, vérifiés avec le solveur SMT Z3. Divulgation : les auteurs sont affiliés à Cobalt AI, dont l'étude utilise le pipeline d'analyse, et le jeu de données est publié pour vérification indépendante.
La même étude a roulé une deuxième expérience que je m'attendais franchement à voir aller dans l'autre sens. Ajouter des instructions de sécurité explicites au prompt a déplacé le taux moyen de vulnérabilité de quatre points de pourcentage. Quatre. Une consigne d'écrire du code sécuritaire, c'est une humeur, pas une spécification, et la distance entre les deux c'est tout le sujet de cet article : une exigence nomme l'acteur, l'objet et la frontière dans une phrase contre laquelle on peut tester quelque chose, alors que « fais attention » nomme rien pantoute et peut donc jamais échouer.
Comment une exigence non écrite devient-elle une vulnérabilité crédible ?
En étant crédible. C'est tout le tour de passe-passe. Ça explique pourquoi ces trous-là traversent la revue sans accrocher : du code qui remplit un silence, c'est pas du code bizarre, c'est le code le plus ordinaire du dépôt, exactement ce qu'un développeur parfaitement compétent écrirait lui aussi si personne lui avait parlé de la règle non plus. L'analyseur voit une requête qui marche. Le réviseur voit un billet satisfait pis il passe au suivant, parce que la question de la revue c'est « est-ce que ça fait ce qui était demandé », et la réponse est oui. Oui, toujours oui. Personne voit la phrase qui a jamais été écrite, parce qu'une absence a pas de numéro de ligne où commenter.
Sur le terrain
Moltbook, c'est l'exemple public le plus propre que j'ai trouvé, et ça vaut la peine de le lire avec générosité, parce que le monde impliqué a bien agi une fois au courant. La plateforme, un réseau social d'agents IA devenu viral fin janvier 2026, a été bâtie avec des outils de codage IA. Le 31 janvier à 21 h 48 UTC, Wiz Research contacte le mainteneur : sa base de données Supabase est entièrement lisible et modifiable par n'importe qui. Environ 4,75 millions d'enregistrements, dont 1,5 million de jetons d'authentification d'agents et 35 000 adresses courriel, avec des messages privés contenant des identifiants de tiers. Là, le bout important. La clé publiable qui traînait dans le JavaScript côté client, c'était pas le défaut, parce que cette clé-là est conçue pour être publique et sert d'identifiant de projet. L'accès est censé être gouverné par des politiques Row Level Security sur la base de données elle-même, et dans les mots de Wiz, « this critical line of defense was missing ». Personne avait écrit la phrase « une rangée est lisible uniquement par l'agent qui la possède » comme exigence, fait que rien en aval avait de raison de l'implémenter. Toutes les tables étaient sécurisées à 1 h 00 UTC le 1er février, à peu près trois heures après le premier contact, et Wiz précise que toutes les données consultées pendant la recherche et la vérification du correctif ont été effacées.
Source : Wiz Research, Hacking Moltbook: AI Social Network Reveals 1.5M API Keys, avec la chronologie de divulgation et les correctifs tels que publiés. Secteur : application web grand public bâtie avec des outils de codage IA.
Remarque comme il y a peu de tout ça qui concerne le modèle. Presque rien. Trois lignes de code client qui sont correctes dans n'importe quel tutoriel Supabase sont devenues un passe-partout en production, et la différence entre le tutoriel et la brèche, c'était pas la qualité du code pantoute, c'était une règle d'accès non écrite. La même forme revient partout où un cadriciel offre un défaut sécuritaire qu'il faut choisir : la plateforme fait sa job, le code généré fait sa job, et l'exigence qui était supposée s'asseoir entre les deux a jamais existé dans un artéfact que quelqu'un aurait pu réviser.
Qu'est-ce que ça aurait changé de spécifier la sécurité en amont ?
La question elle-même. Tout le reste en découle, parce que « écris ce point d'accès » et « écris ce point d'accès, où un appelant peut lire uniquement les rangées dont le propriétaire correspond au sujet authentifié, où un appelant non authentifié reçoit un 401 sans corps de réponse, et où un identifiant de compte malformé est rejeté avant d'atteindre la requête », c'est deux jobs différentes avec deux jeux de critères d'acceptation différents. Tu peux écrire un test qui échoue pour la deuxième cet après-midi. Il existe aucun test pour « sois sécuritaire », ce qui explique pourquoi le résultat de quatre points arrête d'être surprenant une fois que tu t'assois avec.
Amazon est arrivé à une version de cette conclusion-là en public, et s'en est plutôt bien tiré. En mars 2026, le Financial Times rapportait un document interne décrivant une série d'incidents récents avec, dans les mots de l'entreprise, un « high blast radius » et reliés à des « Gen-AI assisted changes », listant parmi les facteurs contributifs un usage d'IA générative « for which best practices and safeguards are not yet fully established ». Pas un meilleur modèle. Les ingénieurs juniors et intermédiaires ont maintenant besoin de l'approbation d'un ingénieur senior avant qu'un code assisté par IA atteigne la production, avec une remise à niveau de sécurité de quatre-vingt-dix jours par-dessus. Lis ça comme un contrôle d'exigences plutôt qu'un contrôle de confiance : ça insère quelqu'un de senior qui doit énoncer ce que le changement a le droit de faire, avant qu'il le fasse.
Il y a un test maison pour ça, pis il prend vingt minutes. La règle : personne ouvre le code. Personne. Le but, c'est de voir si la réponse existe ailleurs que dans l'implémentation, parce que si elle vit uniquement là, dans le code, c'est pas une exigence, c'est un accident qui a bien viré jusqu'ici. Trois points d'accès déployés ce trimestre avec de l'assistance IA. Trois questions chacun :
- Qui a le droit d'appeler ça, et il arrive quoi à tous les autres ?
- Quelles entrées doit-il refuser, et de quoi le refus a l'air pour l'appelant ?
- Quelle personne nommée a confirmé ces deux réponses-là avant que l'ouvrage commence ?
Si la troisième réponse c'est personne, les deux premières sont des suppositions. Chanceuses, jusqu'ici. Pis c'est pas un jugement sur ton monde, c'est juste la sortie parfaitement prévisible d'un processus qui attrapait ces affaires-là par accident plutôt que par design, année après année, sans que personne trouve ça bizarre. Un développeur hésitait devant une règle d'accès. Il se levait. Il allait cogner deux portes plus loin, pis quelqu'un qui savait lui répondait en trente secondes. Trente secondes. Et l'hésitation, c'est exactement ce que la génération a enlevé.
Rien là-dedans est un argument pour ralentir, pis je serais hypocrite d'en faire un. La vitesse est correcte. Le problème est ailleurs : on roule à la vitesse de la machine contre une spec écrite pour un monde plus lent, une spec qui s'appuyait discrètement sur l'hésitation humaine comme dernière ligne de défense. Et la porte que la plupart des équipes opèrent encore vérifie si le code correspond à la spec plutôt que si la spec était complète. Tsé. Ce qui doit remplacer l'hésitation, c'est la phrase elle-même : écrite avant la génération, assez précise pour qu'une personne pis un test puissent la vérifier tous les deux. C'est l'ouvrage que Specira fait. Cinq agents spécialisés interrogent vos entrevues, vos billets et vos politiques sous des angles experts délibérément différents, et un Red Team Critic attaque ce qu'ils produisent en chassant exactement la frontière que personne a énoncée. Je le construis. Fait que escompte la vente pis juge le mécanisme.
À retenir
Un assistant de codage IA peut pas violer une exigence de sécurité qui n'a jamais été écrite comme exigence. Il peut juste deviner. Pis il devine bien : de façon crédible, constante, dans du code qui passe la revue sans lever un sourcil, ce qui est précisément ce qui fait survivre le trou à tous les contrôles que t'as en aval. En amont. C'est là que ça se règle, pis c'est plate. Écris la règle d'accès, la frontière de validation des entrées pis l'exception d'authentification comme des phrases testables avant que quoi que ce soit génère contre elles, attache un nom de personne à chacune, et le défaut du modèle arrête d'être la chose qui décide.
Qu'est-ce qui transforme une règle de sécurité supposée en une règle que le modèle peut pas deviner?
Écrivez-la. Dans une séance Specira, la note de l'analyste en sécurité atterrit sous la réponse du meneur, et elle demande qui est autorisé, ce qui se journalise, et ce que le système fait quand la vérification échoue, pendant que la personne qui connaît la réponse est encore dans la conversation. Cette note devient une exigence avec des critères d'acceptation et des sources citées. L'acheminement décide ensuite qui doit signer l'étape sécurité, et la porte d'export refuse de relâcher le paquet tant que c'est pas fait.
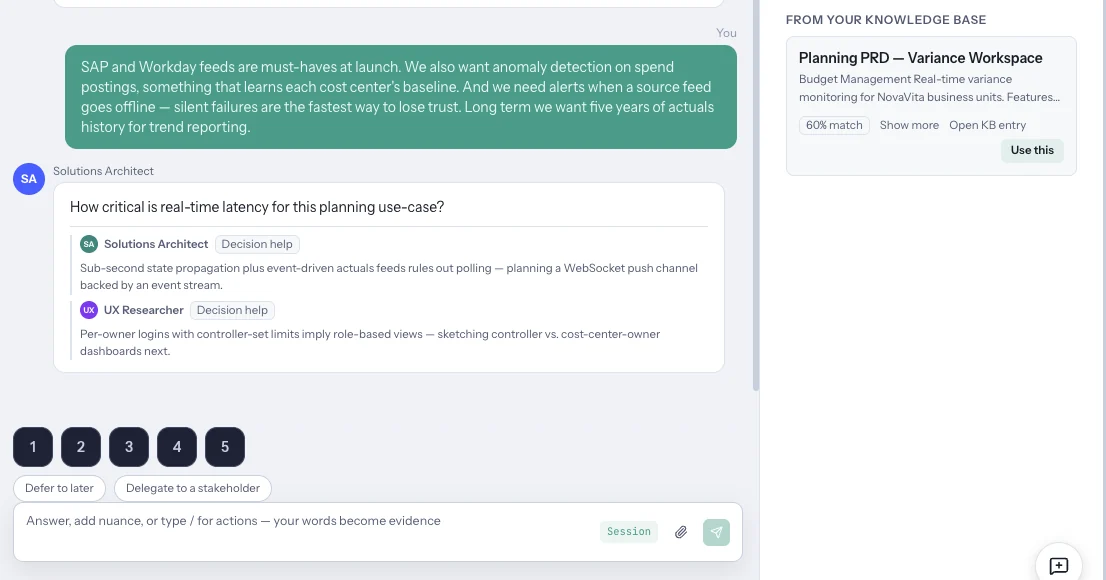
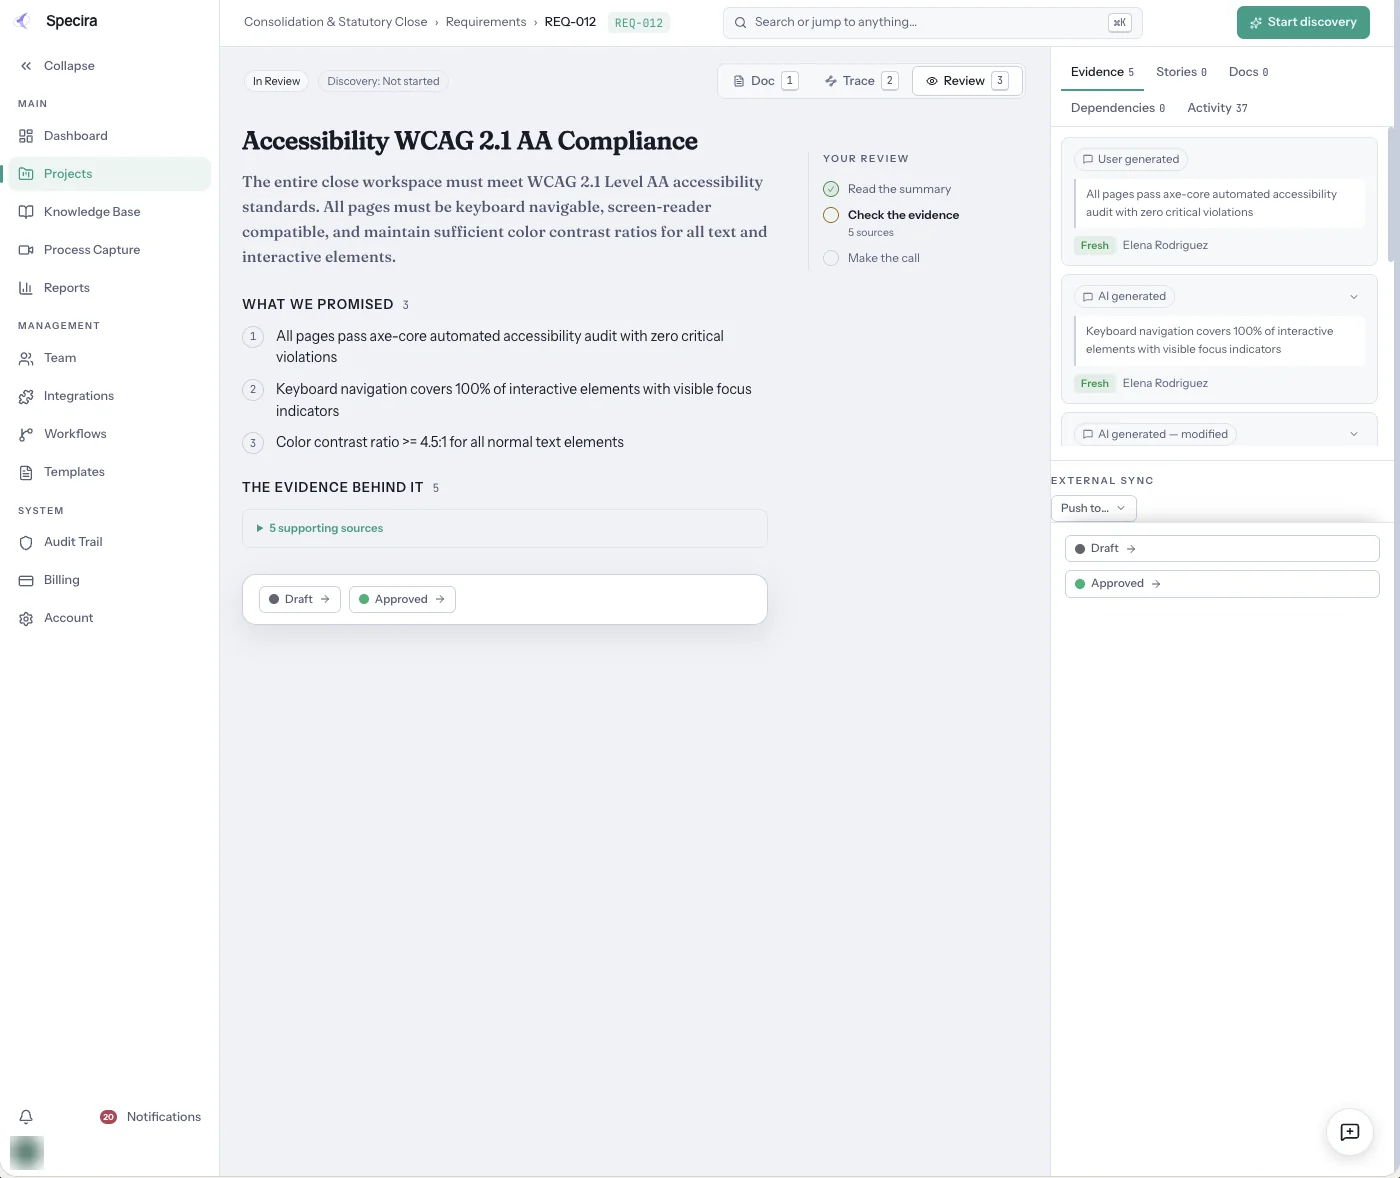
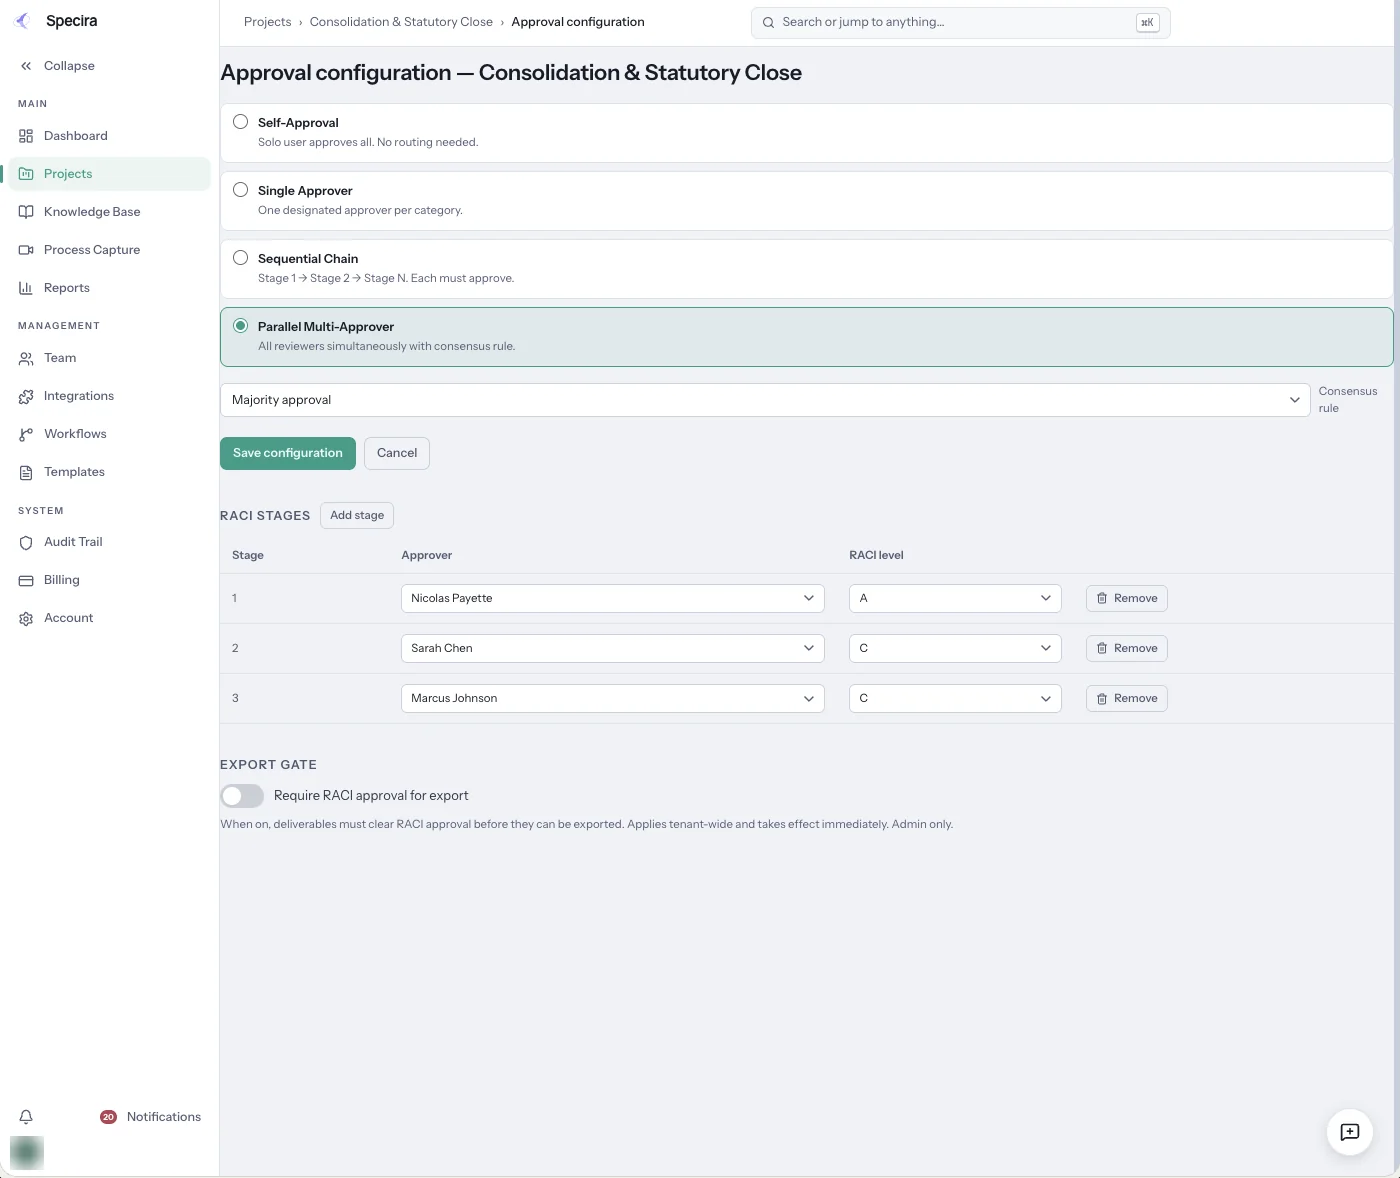
Ce que vous voyez. La note de découverte, c'est l'analyste en sécurité qui la soulève sur le coup, le détail de l'exigence, c'est là qu'elle devient vérifiable, et la configuration des approbations, c'est qui doit signer avant que ça parte.
Dites-nous la règle d'autorisation que votre équipe a jamais écrite. On vous montre à quoi elle ressemble en exigence avec un réviseur.
Réserver une démoÉcrans tirés d'un espace de démonstration Specira; compteurs et scores sont des données d'exemple.
Quelles sont les questions les plus fréquentes sur le code généré par IA et les exigences de sécurité ?