Sept mois, c'est assez pour oublier pourquoi on a écrit quelque chose. Une ingénieure ouvre une tâche que son équipe a rédigée en février, lit la description, la relit, puis ouvre le test qui la corrige. Le test veut un avertissement de dépréciation. Il le veut avec une chaîne de caractères exacte, virgule pour virgule, et cette formulation-là s'est décidée dans une discussion de pull request que la description ne mentionne jamais et que la personne qui répond ne verra jamais. Personne n'est incompétent ici. La description se tient. Le test se tient. C'est l'exigence censée relier les deux qui vit seulement dans un fil que personne n'a pensé à recopier.
Ce cas-là n'est pas inventé. C'est l'échantillon SWE-bench scikit-learn__scikit-learn-14520, et OpenAI s'en est servi en août 2024 comme exemple pour montrer qu'un banc d'essai auquel toute l'industrie faisait confiance était tranquillement injuste envers les modèles qui le passaient. Deux ans plus tard, le même labo publie une version plus dure de la même conclusion. Cette fois, ça portait sur le banc d'essai qu'il avait lui-même dit à tout le monde d'adopter.
Qu'est-ce qu'OpenAI a retiré au juste, et pourquoi ?
Une recommandation. Pas un banc d'essai, et la nuance se perd tout le temps dans la couverture médiatique, ce qui change complètement de qui on parle. SWE-Bench Pro appartient à Scale AI, qui l'a bâti comme successeur de SWE-bench Verified, avec des tâches plus longues et plus difficiles à contaminer. En février 2026, OpenAI a conclu que Verified ne séparait plus les modèles capables des autres, et a pointé la communauté de recherche vers le banc d'essai de Scale, se rendant du même coup le plus gros endosseur institutionnel d'un jeu de données qu'il n'avait pas bâti. Le 8 juillet 2026, dans un billet intitulé « Separating signal from noise in coding evaluations », il a retiré sa recommandation.
La forme de l'audit tient dans un paragraphe. Un pipeline automatisé de qualité des données a lu les instructions des tâches, les tentatives des modèles et les tests de correction, puis a signalé 286 des 731 tâches publiques comme potentiellement brisées. Ce sous-ensemble est passé ensuite par deux révisions plus profondes et volontairement indépendantes : des agents enquêteurs basés sur Codex, avec accès au dépôt et à l'exécution des tests, et une campagne d'annotation humaine où cinq ingénieurs logiciels expérimentés jugeaient chaque tâche. Le pipeline a conclu à 200 tâches brisées. Les humains ont dit 249. OpenAI a estimé environ 30 % et a recommandé aux développeurs de modèles d'examiner attentivement tout résultat tiré du banc d'essai.
Vient ensuite la partie qui devrait intéresser quiconque écrit des critères d'acceptation pour gagner sa vie, et ce n'est pas le pourcentage. OpenAI a classé le brisé en quatre catégories : des tests trop stricts qui imposent des détails d'implémentation jamais précisés dans le prompt, des prompts sous-spécifiés qui omettent des exigences que les tests cachés vérifient et qu'on ne peut pas raisonnablement déduire, des tests à faible couverture qui vérifient trop peu la fonctionnalité demandée, donc un correctif incomplet passe, et des prompts trompeurs qui pointent vers le mauvais comportement ou contredisent ce que les tests exigent. Lis-les en bloc plutôt qu'en liste. Chacune des quatre est un défaut dans le lien entre une exigence énoncée et le critère servant à l'accepter. Ce lien-là, c'est toute la job.
~30 % de 731 tâches
L'audit d'OpenAI sur le volet public de SWE-Bench Pro estime qu'environ 30 % des 731 tâches sont brisées. Deux chemins de révision indépendants ont divergé sur le compte et convergé sur la direction : le pipeline automatisé a signalé 200 tâches (27,4 %), la campagne d'annotation humaine en a signalé 249 (34,1 %), et leurs jugements de catégorie se recoupaient dans 74 % des cas. OpenAI précise aussi que dans aucune tâche signalée l'étiquette humaine la plus fréquente n'a été « pas brisée ». Pendant la même période, les modèles de pointe étaient passés d'un taux de réussite de 23,3 % à 80,3 % sur ce volet en huit mois, ce qui explique en partie pourquoi le bruit est resté invisible aussi longtemps.
Source : OpenAI, « Separating signal from noise in coding evaluations », publié le 8 juillet 2026. Industrie : évaluation des agents de codage IA. SWE-Bench Pro est le banc d'essai de Scale AI ; ce qu'OpenAI retire, c'est sa propre recommandation antérieure de l'adopter, pas le banc d'essai. La taxonomie en quatre catégories et tous les chiffres viennent d'OpenAI ; la lecture voulant que les quatre soient des défauts d'exigence est la nôtre.
Comment un labo d'IA bien financé finit-il avec des exigences ambiguës ?
En récoltant des spécifications dans un endroit qui n'a jamais écrit de spécifications. OpenAI est direct là-dessus dans sa propre section de discussion, et c'est le paragraphe le plus utile du billet : les demandes et les pull requests des dépôts ouverts ont été créées pour de la collaboration entre humains, souvent à travers de longs échanges entre mainteneurs et contributeurs, fait que les descriptions de problème, le code fusionné et les tests unitaires ne s'alignent pas toujours en tâches propres et isolées. Puis la phrase qui mériterait d'être imprimée et collée au-dessus de pas mal de bureaux. Les tests inclus dans une pull request peuvent être trop stricts parce qu'ils sont écrits pour valider un changement précis, pas pour définir un standard indépendant de l'implémentation.
J'ai envie de dire que l'erreur, c'était la source. Ben non, ou en tout cas pas juste ça, et je me suis fait changer d'idée deux fois en écrivant ce texte. Aller chercher dans l'historique réel d'un dépôt, c'est exactement ce qui rend ces bancs d'essai intéressants, et un jeu synthétique écrit proprement à partir de rien mesurerait quelque chose de moins réel. Le défaut en dessous est plus subtil et pas mal plus familier pour quiconque a hérité de la suite de tests de quelqu'un d'autre : un test écrit par la personne qui connaît déjà la réponse encode sa réponse, pas l'exigence. Les tests passent. Personne peut te dire à quoi ils servent.
Et les chiffres l'ont caché. Les modèles de pointe sont passés d'un taux de réussite de 23,3 % sur ce volet de 731 tâches à 80,3 % en huit mois, ce qui ressemblait sur le coup à un gain de capacité rapide et qui était en partie un banc d'essai qui dérivait vers son propre plafond de bruit. Personne ne mentait. La mesure mesurait tranquillement quelque chose d'à côté de ce que tout le monde pensait mesurer, et c'est le mode de défaillance qui survit le plus longtemps, parce qu'il ne produit jamais de message d'erreur.
Qu'est-ce que ça change pour la collecte des exigences par IA ?
Ça change ce que l'expression doit vouloir dire. La plupart des outils vendent la collecte des exigences par IA comme un modèle qui résume une transcription, ce qui n'aurait attrapé aucune des quatre catégories. Regarde qui a échoué ici avant de décider que c'est un problème de discipline. Scale AI a bâti SWE-Bench Pro exprès comme une amélioration de qualité, et le résumé de son propre article scientifique affirme que toutes les tâches sont vérifiées par des humains et enrichies avec assez de contexte pour être résolubles. On savait que l'ambiguïté était l'ennemi. On a conçu contre elle, on a vérifié contre elle, et un audit indépendant a quand même trouvé du brisé dans à peu près trois tâches sur dix.
Fait que quand une rétrospective atterrit sur « la prochaine fois, on va écrire des exigences plus claires » et que la salle hoche la tête, remarque que rien n'a été décidé. Cette phrase suppose que l'ingrédient manquant était l'effort ou le soin, et la preuve devant nous, c'est deux des organisations d'ingénierie les mieux financées de l'industrie qui en mettent énormément des deux et qui arrivent quand même à 30 %. L'effort n'a jamais été l'intrant qui manquait. J'ai défendu une version de ça avant, dans le texte sur les spécifications comme vrai problème et encore dans la vérité plus dure sur pourquoi les spécifications gagnent, et chaque fois j'ai sous-estimé à quel point le correctif est structurel plutôt que comportemental.
Vu sur le terrain
La moitié encourageante de l'histoire a deux ans de plus que le retrait, et c'est elle qui prouve que la méthode marche. En août 2024, OpenAI a travaillé avec 93 développeurs Python professionnels pour passer au crible le jeu de test original de SWE-bench, en annotant 1 699 échantillons pris au hasard contre deux questions : est-ce que la description du problème est sous-spécifiée, donc injuste à tester, et est-ce que les tests unitaires FAIL_TO_PASS éliminent des solutions valides ? Chaque échantillon a été étiqueté indépendamment par trois annotateurs distincts. La règle d'agrégation, c'est le bout à voler : on gardait l'étiquette la plus sévère des trois, donc un seul réviseur qui voit un problème suffisait à jeter l'échantillon, sur le raisonnement explicite qu'il est facile de manquer un problème par accident et que les problèmes eux-mêmes peuvent être ambigus. La campagne a signalé 38,3 % des échantillons pour un énoncé de problème sous-spécifié et 61,1 % pour des tests unitaires susceptibles de marquer injustement une solution valide comme incorrecte, et a filtré 68,3 % du jeu au complet. Ce qui a survécu est sorti sous le nom de SWE-bench Verified, un sous-ensemble de 500 échantillons, avec les annotations complètes et un nouveau harnais d'évaluation conteneurisé bâti avec les auteurs originaux de SWE-bench. L'échantillon scikit-learn du début de ce texte, avec sa chaîne de dépréciation, c'est le cas qu'OpenAI a publié pour montrer ce que le crible attrapait. Des deuxièmes lecteurs l'ont trouvé. Personne d'autre avant eux.
Source : OpenAI, « Introducing SWE-bench Verified », publié le 13 août 2024. Industrie : évaluation des agents de codage IA, un domaine où la spécification et ses critères d'acceptation sont le produit au complet. Les chiffres viennent des résultats d'annotation d'OpenAI ; le taux de filtrage de 68,3 % est décrit par OpenAI comme volontairement conservateur, vu qu'un seul signalement d'annotateur suffisait à retirer un échantillon.
Ça vaut la peine de s'asseoir sur un chiffre là-dedans. Pas le 38,3 %, qui est à peu près ce que devinerait n'importe qui ayant déjà audité un carnet de commandes. Le 61,1 % : plus de la moitié des tâches avaient des critères de correction capables de recaler une bonne réponse, écrits par des ingénieurs compétents, en public, sur un jeu de données contre lequel tout le domaine se notait. Les critères d'acceptation dérivent loin de l'exigence bien plus facilement que l'exigence dérive loin du besoin, et presque personne ne révise les deux ensemble.
Comment une revue adverse attrape ce qu'un seul auteur manque ?
En brisant l'hypothèse qui cause toute la défaillance : qu'un auteur peut évaluer sa propre clarté. Il ne peut pas. Personne ne peut, et ce n'est pas un défaut de caractère, c'est ce que le fait de savoir quelque chose te fait. L'auteur connaît la chaîne de dépréciation, donc la tâche a l'air complète d'où il est debout, et la seule façon de découvrir qu'elle ne l'est pas, c'est de la donner à quelqu'un qui ne sait pas et de regarder où il trébuche.
Les deux audits d'OpenAI utilisent la même forme, à deux ans d'écart, et les détails se répondent d'une manière plus instructive que chaque audit pris tout seul. En 2024, c'était trois annotateurs par échantillon, agrégés vers la pire étiquette. En 2026, c'était cinq ingénieurs par tâche signalée, et l'ordre était explicite : les réviseurs se faisaient une opinion indépendante à partir de l'énoncé visible, des cas de test et de la solution de référence, avant d'utiliser l'analyse du pipeline ou la transcription comme contexte de soutien. Lire à froid. Trancher. Regarder la preuve de soutien après, jamais l'inverse, parce que le contexte contamine un jugement sur la clarté à la seconde où il arrive.
Remarque aussi sur quoi les deux chemins n'étaient pas d'accord, parce que c'est habituellement traité comme un défaut alors que c'est la trouvaille. Le pipeline disait 200, les humains disaient 249, et leurs jugements de catégorie se recoupaient dans 74 % des cas, avec le plus gros écart sur les tests à faible couverture, que les humains ont désignés comme le problème le plus fréquent pour 9,4 % du banc d'essai contre 4,1 % pour le pipeline. Deux lecteurs attentifs, même artefact, comptes différents. C'est à ça que ressemble un jugement vraiment difficile vu de l'extérieur, et c'est le meilleur argument disponible contre l'idée qu'une seule signature d'approbation sur un document d'exigences prouve quoi que ce soit. On a écrit sur le même trou du côté des agents de codage dans le texte sur le vibe coding qui n'a pas réglé le problème des spécifications.
C'est ça que la collecte des exigences par IA doit vouloir dire si l'expression veut mériter sa place : pas un modèle qui résume une transcription, mais une lecture adverse de la spécification avant que quiconque construise contre. Ce mécanisme-là, c'est ce sur quoi Specira est bâti, fait que pèse le discours de vente en conséquence et juge le mécanisme plutôt que la promesse. Cinq agents spécialistes interrogent les entrevues, les billets et les politiques sous des angles d'expert volontairement différents, et un Red Team Critic attaque ce qu'ils produisent, à la chasse à l'exigence que quelqu'un a jugée trop évidente pour l'écrire. Adverse par construction. Ça roule avant que les critères d'acceptation soient écrits, le seul moment où tout ça coûte pas cher.
À retenir
OpenAI a audité un banc d'essai qu'il avait recommandé, a estimé qu'environ 30 % de ses 731 tâches étaient brisées, et a retiré la recommandation. Les quatre catégories de défaillance qu'il nomme décrivent toutes une exigence et son critère d'acceptation qui se contredisent, et aucune ne décrit un modèle en dessous de ses moyens. Le retrait, c'était le geste responsable. Le défaut était en amont, au moment de la rédaction. Le soin n'a jamais manqué. Si les labos les mieux financés de l'industrie n'arrivent pas à écrire des spécifications non ambiguës juste en faisant attention, alors « écrivez de meilleures exigences » n'est pas un conseil. Ce qui a marché, deux fois, c'est un lecteur qui n'avait pas écrit la spécification, qui voyait seulement ce que la personne qui répond allait voir, et dont la job était de trouver le trou plutôt que d'approuver le document.
Comment un deuxième lecteur aurait-il attrapé une tâche en désaccord avec son propre test?
Un deuxième lecteur. Specira laisse jamais un seul auteur être le seul lecteur : quatre autres agents écrivent leurs notes sous la réponse du meneur, et le mandat complet du critique Red Team, c'est de trouver l'endroit où l'exigence énoncée et le résultat promis concordent pas. L'ambiguïté apparaît comme un désaccord, par écrit. Le détail de l'exigence rend ensuite l'écart évident, parce que les critères d'acceptation sont collés à l'affirmation qu'ils sont censés tester, et le panneau des participants nomme qui peut trancher.
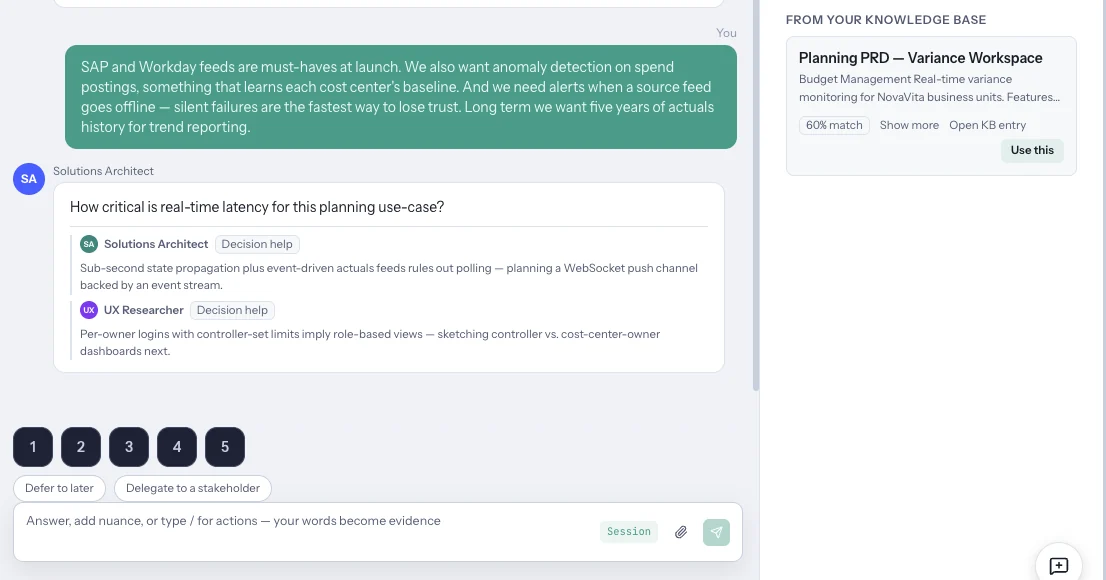
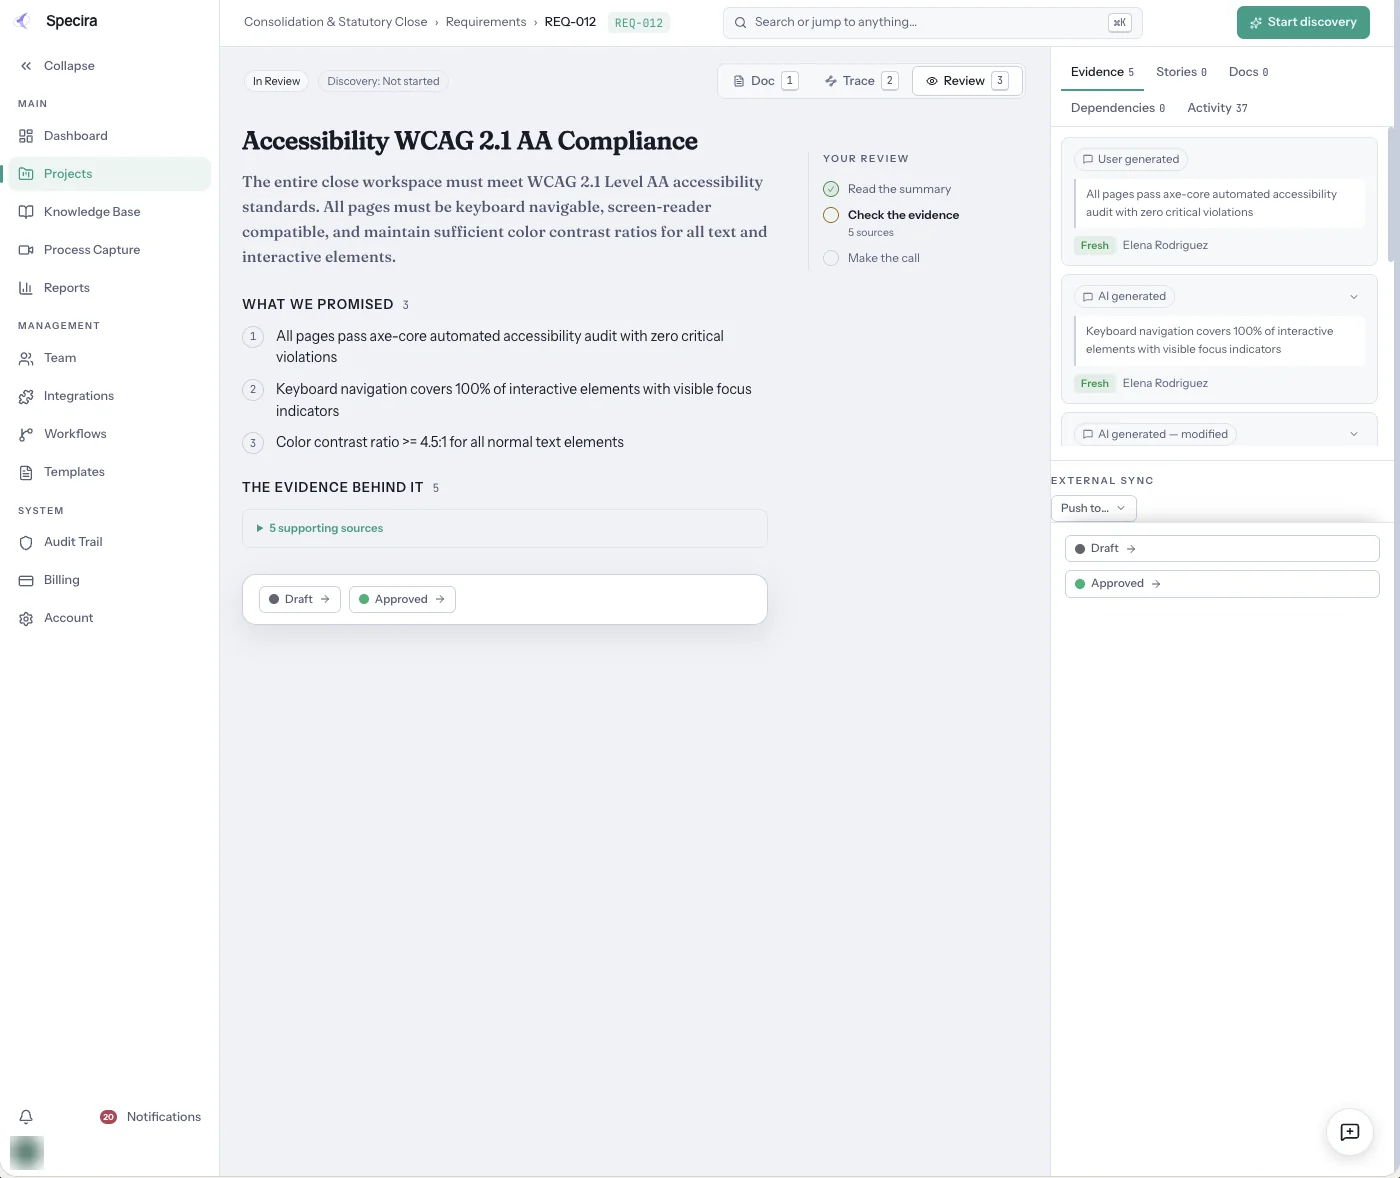
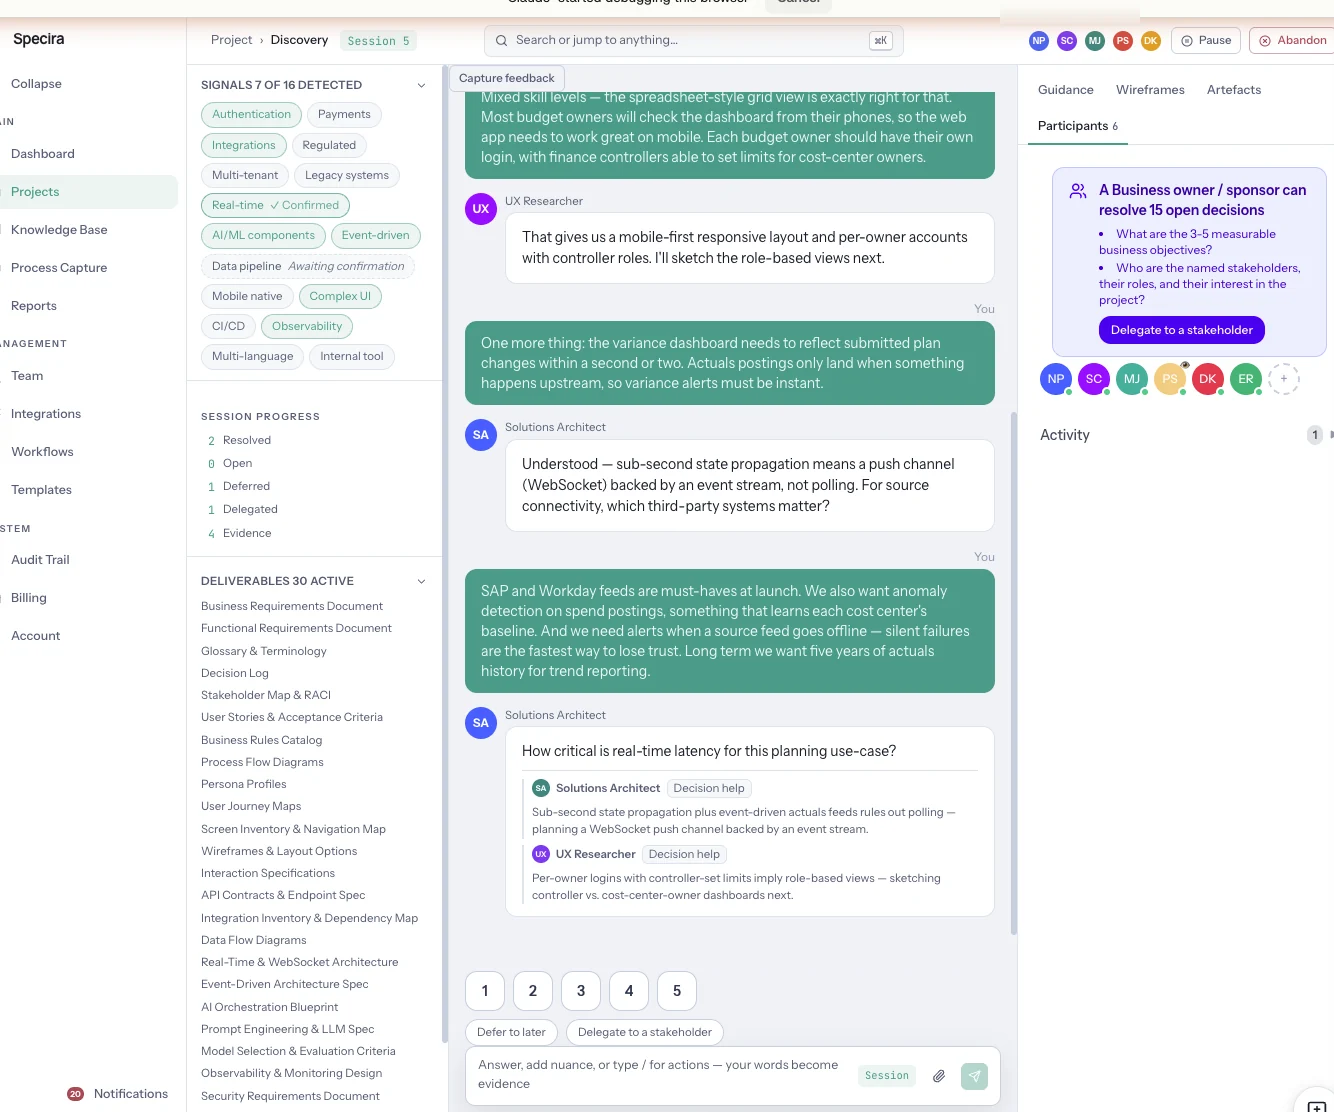
Ce que vous voyez. Les notes de découverte, c'est quatre autres lecteurs sur la même réponse, le détail de l'exigence met les critères d'acceptation à côté de l'affirmation, et le panneau des participants nomme qui tranche le désaccord.
Apportez une spécification de tâche que vous jugez sans ambiguïté. On met un deuxième et un troisième lecteur dessus.
Réserver une démoÉcrans tirés d'un espace de démonstration Specira; compteurs et scores sont des données d'exemple.
Quelles sont les questions les plus fréquentes sur les bancs d'essai IA et la qualité des exigences ?